먼저 알아 둘 용어
이 사이트에서 쓰는 용어를 세 묶음으로 정리했습니다. 각 용어의 → 링크를 누르면 그 용어가 쓰이는 곳으로 갑니다.
픽셀 자동화는 왜 어려운가?
- 픽셀 아트는 "격자 하나, 한 칸에 한 색"이라는 엄격한 규칙이 있습니다.
- 이미지 생성 모델은 사진처럼 부드러운 이미지를 만들도록 학습되었습니다. 그래서 규칙을 지키지 못하고 "픽셀처럼 보이는 그림"을 만듭니다.
- 코드는 규칙을 정확히 지킵니다. 그러나 코드만으로는 그 반려동물과 닮은 그림을 만들기 어렵습니다.
- 이 파이프라인은 두 방법을 나눠 씁니다. 이미지 모델은 "닮게 그리기"를 맡습니다. 코드는 "칸 확정"을 맡습니다. 비전 모델은 "검사"를 맡습니다.
1.1 목표: 앱에서 바로 쓰는 픽셀 펫
Sticky Pet 앱은 화면 위에 작은 픽셀 반려동물을 띄웁니다. 사용자가 자기 반려동물 사진을 넣으면, 그 동물과 닮은 픽셀 펫을 만들어야 합니다.
결과물은 다음 조건을 모두 지켜야 합니다.
- 작은 격자: 가로·세로 약 32~40칸입니다. 한 칸이 화면의 한 점(픽셀)입니다.
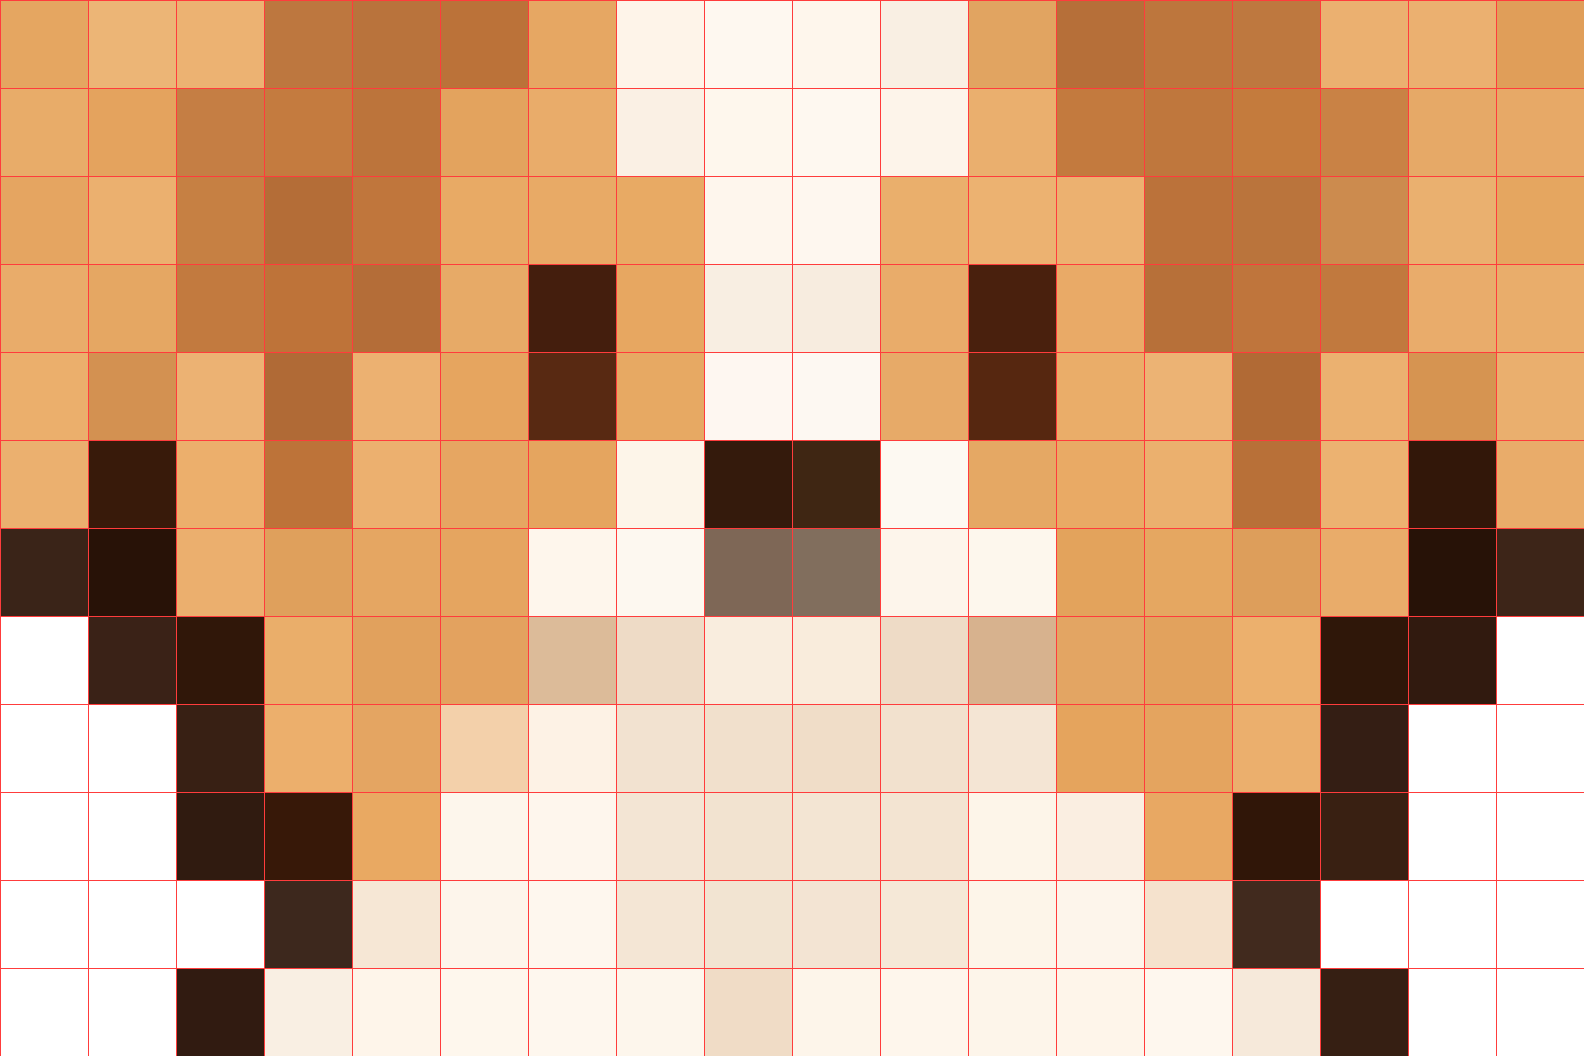
- 한 칸에 한 색: 칸 안에 그라데이션이 없어야 합니다.
- 닫힌 외곽선: 몸 둘레에 끊기지 않는 1칸 두께의 어두운 선이 있어야 합니다.
- 투명 배경: 몸 밖의 칸은 비어 있어야 합니다.
- 닮음: 털 색, 무늬, 귀 모양, 눈 색이 사진 속 동물과 같아야 합니다.
- 일관성: 5개 자세와 모든 애니메이션 프레임에서 같은 동물로 보여야 합니다. 머리 크기와 칸 크기가 같아야 합니다.
- 자동화: 사람이 손으로 고치지 않아야 합니다. 비용과 시간이 작아야 합니다.
1.2 픽셀 아트의 규칙과 "가짜 픽셀"
진짜 픽셀 아트는 세 가지 규칙을 지킵니다.
- 격자 하나: 모든 칸의 크기가 같습니다. 칸은 정수 좌표에만 있습니다.
- 한정된 색: 사람이 그린 스프라이트는 보통 8~32색을 씁니다.
- 단단한 경계: 칸과 칸 사이에 중간색이 없습니다. 중간색으로 경계를 부드럽게 하는 처리를 안티앨리어싱(anti-aliasing)이라고 합니다. 픽셀 아트는 이 처리를 하지 않습니다.
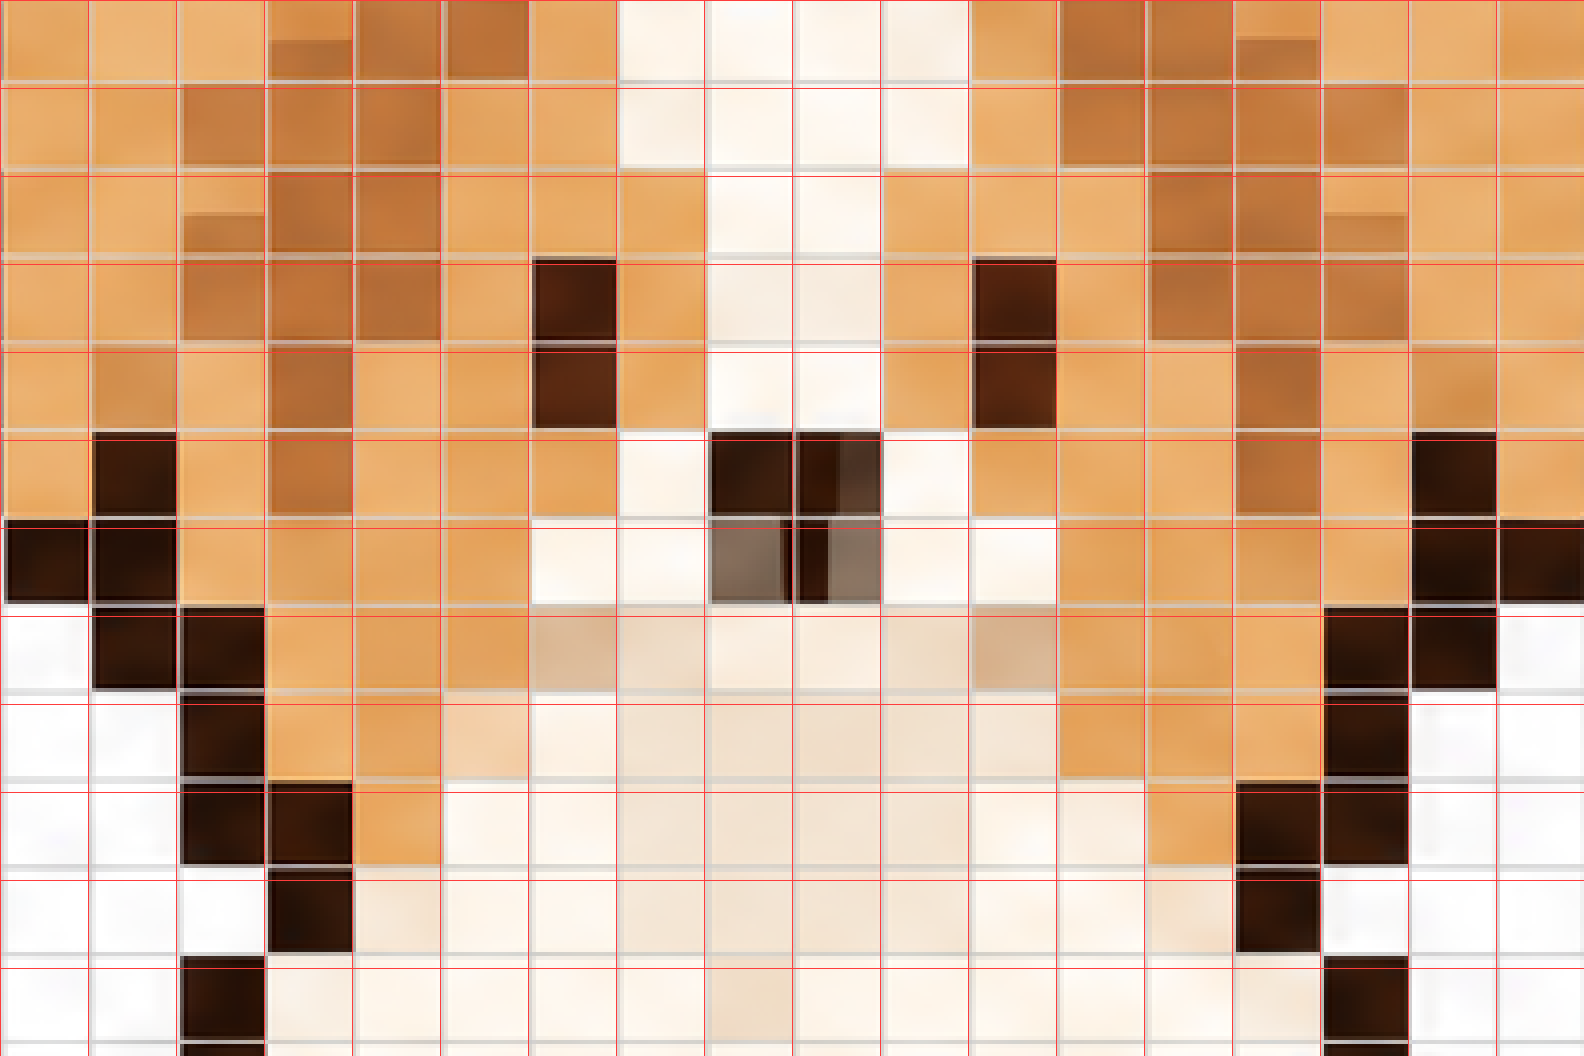
이미지 생성 모델은 보통 1024px 이상의 큰 이미지를 만듭니다. 그 안에 "블록처럼 보이는 무늬"를 그립니다. 이것을 가짜 픽셀(fake pixel)이라고 부릅니다. 가짜 픽셀에는 다음 문제가 있습니다.
- 블록 크기가 위치마다 다릅니다. 격자가 조금씩 밀립니다.
- 한 블록 안에 그라데이션과 번짐이 있습니다.
- 색이 수만 개입니다.
- 1칸 크기의 작은 부분(눈, 코)이 칸 경계에 걸칩니다. 그러면 2~3칸으로 번집니다.
아래는 이 파이프라인의 실제 중간 결과입니다. 왼쪽은 GPT 이미지 모델이 32×32 격자 위에 그린 그림입니다. 오른쪽은 코드가 칸마다 한 색으로 확정한 결과입니다. 빨간 선은 실제 격자입니다.
1.3 기존 이미지 모델의 한계 (GPT, Gemini)
팀은 범용 이미지 모델 두 계열을 직접 시험했습니다. 아래 수치는 팀이 2026년 10~11월에 잰 값입니다. 대부분 5~15장 표본입니다.
GPT 이미지 모델 (OpenAI)
시험한 모델: gpt-image-2, gpt-image 2.5·2.6 계열(실험 환경 ID: sunburst, flare)
- 사진 속 동물과 닮게 그립니다.
- 예시 그림의 화풍을 잘 따라 합니다.
- 격자 없이 "32×32 픽셀 아트"를 요청하면 블록 크기가 22~24px로 제각각이었습니다.
- "8~10색만 써라"고 지시해도 결과는 51~69색이었습니다.
- "정확히 1픽셀만 위로 올려라"는 4번 모두 실패했습니다.
- 여러 캐릭터가 있는 시트를 편집하면 다른 캐릭터도 33~182칸 바뀌었습니다.
- 같은 격자 작업에서 모델·해상도별 단색 칸 비율이 23%~98%로 크게 달랐습니다.
Gemini 이미지 모델 (Google)
시험한 모델: Nano Banana Pro, Nano Banana 2
같은 격자 작업의 단색 칸 비율 (평균)- 장마다 편차가 컸습니다(62~100%).
- 한 장은 발이 기준선 아래로 내려갔습니다.
- 그래서 격자 단계는 GPT 이미지 모델로 정했습니다.
핵심 딜레마
닮게 그립니다. 격자는 지키지 못합니다.
격자는 정확합니다. 사진을 줄이기만 하면 코·귀 같은 특징이 사라집니다.
이미지 모델이 격자 위에 그리게 유도합니다. 코드가 칸을 확정합니다. 비전 모델이 검사합니다.
막대는 이해를 돕는 개념 표시입니다. 측정값이 아닙니다.
1.4 디퓨전 모델은 무엇이고, 왜 픽셀에 약한가
디퓨전 모델(diffusion model)은 현재 이미지 생성 AI의 대표 방식입니다. Stable Diffusion, FLUX 같은 공개 모델이 이 방식입니다.
동작 원리
- 학습: 깨끗한 이미지에 노이즈(무작위 점)를 조금씩 더합니다. 모델은 "더해진 노이즈"를 맞히도록 학습합니다.
- 생성: 완전한 노이즈에서 시작합니다. 모델이 노이즈를 조금씩 빼는 과정을 여러 번(보통 20~50 스텝) 반복합니다.
- 조건: 텍스트 프롬프트는 숫자 벡터(임베딩)로 바뀝니다. 모델은 어텐션(attention)으로 이 벡터를 참고하며 노이즈를 뺍니다.
- 잠재 공간: 많은 모델은 이미지를 바로 다루지 않습니다. VAE라는 압축기가 이미지를 가로·세로 약 1/8 크기의 잠재 공간(latent space)으로 줄입니다. 디퓨전은 이 작은 공간에서 일어납니다. 마지막에 VAE 디코더가 원래 크기로 되돌립니다.
개념도: 노이즈에서 시작해 단계적으로 그림이 드러나는 모습입니다. 실제 모델 출력이 아닙니다.
픽셀 아트에 약한 이유
- 디코더가 부드러움을 선호합니다. VAE 디코더는 사진으로 학습했습니다. 그래서 날카로운 1칸 경계를 둥글게 만듭니다.
- 정수 격자 개념이 없습니다. 잠재 공간의 한 점은 실제 이미지의 약 8×8 영역을 대표합니다. "모든 블록이 정확히 N×N"이라는 규칙을 강제하는 장치가 없습니다. 그래서 블록이 15px, 17px처럼 흔들립니다.
- 학습 데이터가 깨끗하지 않습니다. 인터넷의 픽셀 아트 이미지 다수는 확대되거나 JPEG로 압축되어 있습니다. 모델은 그 번진 모습을 배웁니다.
- 프레임 사이 일관성이 없습니다. 이미지를 한 장씩 만들면 칸 위치가 프레임마다 달라집니다. 애니메이션에서 몸이 떨립니다.
팀이 시험한 디퓨전·픽셀 전용 방식
| 방식 | 결과 | 판단 |
|---|---|---|
| 로컬 ComfyUI + NoobAI-XL + 픽셀 LoRA | 1024px 픽셀풍 이미지가 나왔습니다. 진짜 격자로 줄이는 후처리가 따로 필요했습니다. img2img로 모서리를 고치는 시도는 실패했습니다. | 미채택 |
PixelLab generate-image-v2 | 진짜 픽셀이 나왔습니다. 그러나 37~41색이었습니다(앱 기존 펫은 7색). 몸 안쪽에 검은 선과 음영이 생겼습니다. | 화풍 불일치 |
PixelLab image-to-pixelart | 눈·코가 점이나 줄로 뭉개졌습니다. Pro Flash는 출력이 513×506px라 32칸 고정이 안 됐습니다. | 미채택 |
PixelLab animate-pixminimax | 정지 픽셀 이미지를 받아 픽셀 그대로 움직이는 프레임을 만듭니다. | 애니메이션 단계에 채택 |
파이프라인 직접 체험하기
내 사진으로 직접 돌려보기
연결 확인 중…- 체험 코드를 넣습니다.
- 반려동물 사진 1장을 넣습니다. 끌어 놓기, 파일 고르기, 붙여넣기(⌘V / Ctrl+V) 모두 됩니다. 몸 전체가 보이는 사진이 좋습니다.
- 파이프라인 실행을 누릅니다. 약 4~7분 걸립니다. 단계가 끝날 때마다 결과가 아래에 나타납니다.
- 끝나면 결과가 아래 "단계별로 넘겨 보기"에 내 사진으로 추가됩니다.
한눈에 보는 순서
단계별로 넘겨 보기
아래는 실제 실행 기록입니다. 직접 돌린 결과는 "내 사진"으로 맨 앞에 추가됩니다. 모든 이미지는 파이프라인이 만든 실제 중간 파일입니다.
- 반려동물을 고릅니다.
- 단계 카드를 누르거나 다음 ▶을 누릅니다. 자동 재생을 누르면 단계가 차례로 넘어갑니다. 키보드 ←, →도 됩니다.
- 오른쪽 칸에서 그 단계에 쓴 방법·원리·모델·도구의 이름과, 그 단계에서 버린 대안을 확인합니다.
점 색: GPT 이미지Jev코드GPT-5.4-miniPixelLab
각 과정의 방법·원리·모델·도구
각 항목은 같은 순서로 씁니다. 그림 → 무엇인가 → 왜 골랐나 → 다른 대안 → 동작 방식 → 이 단계에서 버린 대안입니다.
한눈에 보는 순서와 판단 분기
항목 목록
파이프라인을 만든 과정
팀은 2026년 10월부터 11월 19일까지 약 6주 동안 이 파이프라인을 만들었습니다. 현석님이 방향을 정하고 결과를 판정했습니다. AI 코딩 에이전트가 실험 코드 작성과 측정을 도왔습니다.
- 손작업과 단순 축소로 시작했습니다. 특징이 사라졌습니다.
- 픽셀 전용 생성(PixelLab, 디퓨전)을 시험했습니다. 화풍이 맞지 않았습니다.
- GPT 이미지 모델에게 "격자 위에 그리기"를 시켰습니다. 예시와 같은 크기의 칸을 주자 단색 칸 비율이 82%에서 약 98%로 올랐습니다.
- 코드 검사와 Jev 비전 판정을 붙여 자동 합격·재시도를 만들었습니다.
- 레퍼런스 시트로 5자세를 한 번에 만들고, PixelLab으로 움직임을 붙였습니다.
시도했다가 버린 대안 (단계별)
대안을 파이프라인 단계에 연결했습니다. 체험을 누르면 그 단계의 실제 화면으로, 기술을 누르면 그 단계의 기술 설명으로 갑니다.
참고한 연구
- Gerstner 외, "Pixelated Image Abstraction" (NPAR 2012 / Computers & Graphics). 사진을 팔레트와 격자로 줄이는 고전 방법입니다.
- Han 외, "Deep Unsupervised Pixelization" (SIGGRAPH Asia 2018).
- Wu 외, "Make Your Own Sprites: Aliasing-Aware and Cell-Controllable Pixelization" (ACM TOG 41(6), 2022).
- Kopf & Lischinski, "Depixelizing Pixel Art" (SIGGRAPH 2011).
- Binninger & Sorkine-Hornung, "SD-πXL: Generating Low-Resolution Quantized Imagery via Score Distillation" (SIGGRAPH Asia 2024).
- "Sprite Sheet Diffusion: Generate Game Character for Animation" (arXiv 2412.03685).
- ventz/pixel-perfect, "Fixing pixel art at generation time" (GitHub 문서). 디퓨전이 진짜 픽셀을 못 만드는 구조적 이유를 정리합니다. 링크
- Retro Diffusion, "Why AI Pixel Art Looks Wrong". 링크
논문용 자료 다운로드
논문과 발표에 바로 쓸 수 있도록 이미지를 모았습니다. 모든 파일은 원본 해상도 PNG(애니메이션은 GIF·MP4)입니다.
- 5.1 논문용 도판: 과정을 설명하는 표시(상자·라벨)를 그려 넣은 완성 그림과 다이어그램입니다.
- 5.2 실행별 원본 자료: 파이프라인이 만든 모든 중간 결과물입니다. 단계 순서로 정리했고 파일마다 설명이 있습니다.